PDF na Word
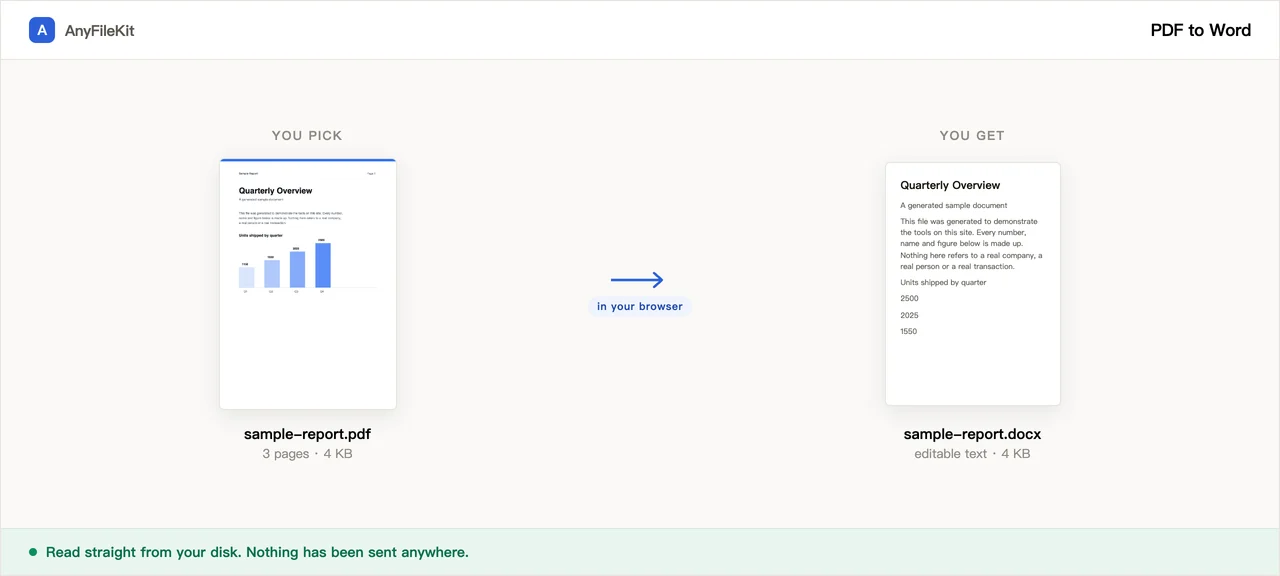
PDF nie zawiera akapitów, tylko znaki z położeniem na stronie. Ta strona odczytuje te położenia z powrotem i na nowo wyprowadza z nich akapity, nagłówki i kolejność czytania. Na zwykłym dokumencie jednołamowym wychodzi to dobrze, na wszystkim złożonym w siatkę źle. Po każdym przebiegu narzędzie mówi, który z tych dwóch przypadków wystąpił.
- Bez konta
- Bez znaku wodnego
- Bez limitu rozmiaru
Twoje pliki
Najlepiej wychodzi na zwykłych dokumentach jednołamowych. Tabele, strony w kilku kolumnach i wszystko narysowane jako schemat nie przetrwają w całości. Uwagi po przebiegu mówią, co stało się z Twoim plikiem.
Do OCR trafiają tylko strony, na których nie ma w ogóle tekstu. Przy pierwszym uruchomieniu pobierany jest silnik rozpoznawania i jeden wybrany przez Ciebie pakiet języka, razem około 3,5 MB. Potem idzie po kilka sekund na stronę i wraca czysty tekst, bez nagłówków i bez pogrubienia. Tylko druk: pismo odręczne wraca jako bełkot, niezależnie od wybranego języka.
Domyślnie wyłączone, więc akapit przecięty między dwiema stronami PDF zostaje sklejony z powrotem. Włącz, jeśli plik Worda ma dzielić się na strony tak samo jak PDF.
Nic jeszcze nie wybrano.
Co to narzędzie dla ciebie robi
Rzeczy, które warto wiedzieć przed startem.
Akapity, a nie wiersz na akapit
PDF zapisuje wydrukowane wiersze, a nie akapity. To narzędzie skleja wiersze z powrotem, razem ze słowami rozdzielonymi łącznikiem na końcu wiersza, i zaczyna nowy akapit tylko tam, gdzie naprawdę zmienia się interlinia, wcięcie, stopień pisma albo grubość.
Nagłówki stają się nagłówkami Worda
Tekst większy od tekstu głównego jest szeregowany według wielkości i przypisywany do stylów Nagłówek 1, 2 i 3, dzięki czemu okienko nawigacji się zapełnia, a Odwołania → Spis treści działa. Pogrubienie i kursywa biorą się z kroju, którym narysowano dany fragment znaków.
Powtarzające się żywe paginy i numery stron znikają
Wiersze leżące na górnym albo dolnym marginesie, które powtarzają się na połowie dokumentu, oraz same numery stron zostają usunięte. Liczba usuniętych jest podawana.
Mówi, gdzie mu się nie udało
Strony w kilku kolumnach, wiersze wyglądające jak wiersze tabeli, obrazy, których nie dało się wyciąć, tekst ustawiony bokiem i strony całkiem bez tekstu są liczone i wyjaśniane po kolei pod przyciskiem pobierania.
Jak z niego korzystać
Wybierz jeden albo kilka plików PDF. Jeśli są wśród nich skany, przed startem zaznacz pole OCR i wybierz ich język.
Naciśnij Start. Każda strona jest czytana dwa razy, więc długi dokument trochę potrwa.
Pobierz plik .docx, a potem przeczytaj uwagi pod przyciskiem. Jest w nich napisane, co nie przetrwało.
Kiedy się z niego korzysta
Musisz poprawić dwa akapity w cudzym PDF
Wykorzystanie warunków dostawcy, jednego punktu umowy, jednej sekcji raportu.
Wyciągnięcie tekstu bez przepisywania go
Oferta, artykuł albo instrukcja istnieje tylko jako PDF, a tekst główny musi trafić tam, gdzie da się nad nim pracować.
Tego pliku nie można oddać obcemu serwerowi
Umowy, wypisy lekarskie, paski płacowe, wszystko objęte umową o poufności. PDF jest czytany na Twoim komputerze i nic nie jest wysyłane.
Pytania
Czy plik Worda będzie wyglądał jak PDF?
Nie. Tekst wraca w kolejności czytania, w stylach samego Worda, na stronie tej samej wielkości co oryginał, z marginesami wziętymi stamtąd, gdzie tekst naprawdę leży. Miejsca łamania wierszy, dokładne kroje pisma, odstępy między literami, łamy i wszystko narysowane wektorowo nie są odtwarzane.
Co dzieje się z tabelami?
Nie wychodzą jako tabele Worda. Gdy wewnątrz wiersza są szerokie przerwy, te przerwy zamieniają się w znaki tabulacji, a sam wiersz staje się osobnym akapitem, więc dane są w komplecie i we właściwej kolejności. Żeby odzyskać prawdziwą tabelę, zaznacz te wiersze w Wordzie i użyj Wstawianie → Tabela → Konwertuj tekst na tabelę, wybierając tabulatory jako separator. W raporcie jest napisane, ile wierszy wyszło w ten sposób.
A strony w dwóch kolumnach?
Każda kolumna jest czytana po kolei z góry na dół i jest to zgłaszane, żeby można było to sprawdzić. Trzy kolumny działają tak samo. Psuje się to na stronie, na której kolumny zaczynają się i kończą w połowie wysokości, albo gdy boczna ramka nachodzi na tekst główny; takie strony wychodzą poprzeplatane.
Mój PDF to skan, a plik Worda jest pusty.
W zeskanowanej stronie nie ma znaków do odczytania. Zaznacz „Czytaj zeskanowane strony przez OCR”, podaj język skanu, a te strony zostaną rozpoznane. Czytane są angielski, chiński uproszczony i tradycyjny, hiszpański, portugalski i rosyjski, jeden język naraz, więc zły wybór wraca jako bełkot. Zajmuje to kilka sekund na stronę, a wraca czysty tekst, bez nagłówków i bez pogrubienia.
Czy pogrubienie i kursywa są wiarygodne?
Biorą się z kroju, którym narysowano dany fragment znaków, więc są poprawne zawsze wtedy, gdy dokument użył prawdziwego kroju pogrubionego albo pochyłego. Mylą się, gdy PDF udawał pogrubienie, obrysowując każdy znak dwa razy, i mogą się mylić przy zwykłym kroju pochylonym sztucznie. Podkreślenie, kolor tekstu i zakreślenie nie są przenoszone.
Czy mogę przekonwertować kilka plików naraz?
Tak. Z każdego PDF powstaje osobny plik .docx. Powyżej trzech plików przychodzą w jednym zipie. PDF większy niż 2 GB w ogóle się nie otworzy; to ograniczenie przeglądarki.
Czy mój plik jest wysyłany?
Nie. PDF jest czytany z Twojego dysku przez tę stronę, plik Worda powstaje w tej karcie, a pobieranie wychodzi z Twojej przeglądarki. Możesz mieć otwartą kartę sieci i patrzeć, jak to działa. Czytnik PDF i silnik OCR są pobierane z tej witryny przy pierwszym uruchomieniu; Twojego dokumentu w tym ruchu nie ma.
Inne narzędzia
Kompresuj obrazy
Zmniejsz zdjęcia bez wysyłania ich
Kompresuj PDF
Zmniejsz plik PDF bez wysyłania go
Kompresuj wideo
Zmniejsz plik z filmem
Przytnij wideo
Zaznacz ramkę na obrazie i zostaw tylko ten fragment
Wideo na GIF
Zamień fragment filmu w animowany GIF
Połącz pliki PDF
Złóż kilka plików PDF w jeden
Podziel PDF
Wyciągnij strony z pliku PDF
PDF na JPG
Każda strona PDF-a staje się obrazem
Skróć audio
Skróć plik dźwiękowy
Skróć wideo
Skróć film bez kodowania go na nowo
Przytnij obraz
Zaznacz ramkę na zdjęciu, a jeśli trzeba, najpierw je obróć
Połącz obrazy
Kilka zdjęć w jednym pliku
HEIC na JPG
Zamień zdjęcia z iPhone’a na JPG
JPG na PDF
Zamień obrazy JPG i PNG w jeden plik PDF
Wideo na MP3
Wyciągnij dźwięk z filmu
Word na PDF
Zamień .docx w PDF albo w jeden PDF na stronę
Markdown na Worda
Zamień plik .md w .docx
Markdown na PowerPoint
Zamień konspekt w Markdownie w slajdy
Obraz na tekst
Odczytaj tekst z obrazka
Podziel arkusze Excela
Jeden arkusz, jeden plik
Podziel wiersze Excela
Jeden wiersz, jeden plik