PDF เป็น Word
ไฟล์ PDF ไม่ได้เก็บย่อหน้า แต่เก็บตัวอักษรพร้อมตำแหน่งบนหน้ากระดาษ หน้านี้อ่านตำแหน่งเหล่านั้นกลับมาแล้วคำนวณย่อหน้า หัวข้อ และลำดับการอ่านขึ้นใหม่ วิธีนี้ได้ผลดีกับเอกสารคอลัมน์เดียวทั่วไป และได้ผลแย่กับอะไรก็ตามที่จัดวางเป็นตาราง ทุกครั้งที่ทำงานเสร็จ ระบบจะบอกคุณว่าเอกสารของคุณเป็นแบบไหนในสองแบบนี้
- ไม่ต้องสมัคร
- ไม่มีลายน้ำ
- ไม่จำกัดขนาดไฟล์
ไฟล์ของคุณ
ทำได้ดีที่สุดกับเอกสารคอลัมน์เดียวทั่วไป ตาราง หน้าที่จัดเป็นหลายคอลัมน์ และทุกอย่างที่วาดเป็นแผนภาพ จะไม่รอดมาครบถ้วน หมายเหตุหลังทำงานเสร็จจะบอกว่าเอกสารของคุณเป็นอย่างไร
เฉพาะหน้าที่ไม่มีข้อความเลยเท่านั้นที่ถูกส่งไปทำ OCR การทำงานครั้งแรกจะดาวน์โหลดกลไกรู้จำและชุดภาษาหนึ่งชุดที่คุณเลือก รวมกันประมาณ 3.5 MB จากนั้นใช้เวลาหลายวินาทีต่อหน้า และคืนกลับมาเป็นข้อความล้วน ไม่มีหัวข้อและไม่มีตัวหนา อ่านได้เฉพาะตัวพิมพ์ ลายมือจะกลายเป็นข้อความที่อ่านไม่รู้เรื่อง ไม่ว่าคุณจะเลือกภาษาใดก็ตาม
ปิดไว้เป็นค่าเริ่มต้น ย่อหน้าที่ถูกตัดคร่อมสองหน้าของ PDF จึงถูกต่อกลับเข้าด้วยกัน เปิดเมื่อไฟล์ Word ต้องขึ้นหน้าใหม่เหมือนไฟล์ PDF
ยังไม่ได้เลือกอะไรเลย
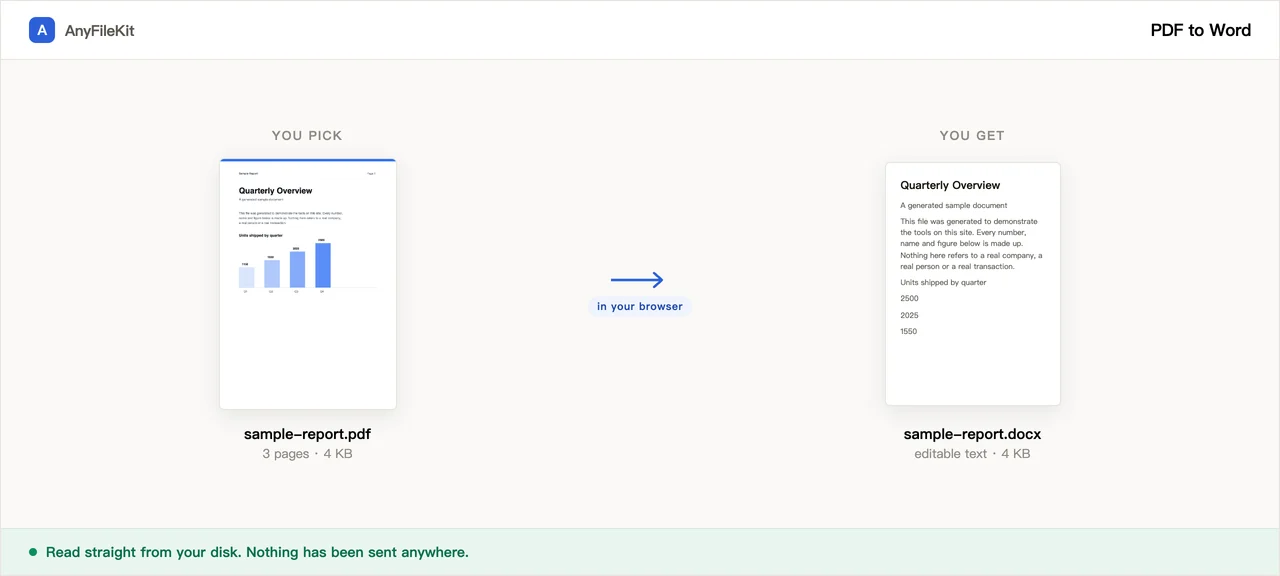
เครื่องมือนี้ทำอะไรให้คุณ
สิ่งที่ควรรู้ก่อนเริ่ม
ได้ย่อหน้า ไม่ใช่บรรทัดละย่อหน้า
ไฟล์ PDF บันทึกบรรทัดที่พิมพ์ออกมา ไม่ใช่ย่อหน้า เครื่องมือนี้ต่อบรรทัดกลับเข้าด้วยกัน รวมถึงคำที่ถูกตัดด้วยยัติภังค์ท้ายบรรทัด และจะขึ้นย่อหน้าใหม่เฉพาะตรงที่ระยะห่างบรรทัด การย่อหน้า ขนาดตัวอักษร หรือความหนาเปลี่ยนไปจริง ๆ
หัวข้อกลายเป็นหัวข้อของ Word
ข้อความที่ตัวใหญ่กว่าเนื้อความจะถูกจัดอันดับตามขนาดแล้วจับคู่กับ Heading 1, 2 และ 3 บานหน้าต่างนำทางจึงมีข้อมูล และ การอ้างอิง → สารบัญ ก็ใช้งานได้ ตัวหนาและตัวเอียงมาจากฟอนต์ที่ใช้วาดตัวอักษรแต่ละช่วง
หัวกระดาษท้ายกระดาษที่ซ้ำและเลขหน้าถูกตัดทิ้ง
บรรทัดที่อยู่ในขอบบนหรือขอบล่างและซ้ำกันเกินครึ่งของเอกสาร รวมทั้งเลขหน้าที่อยู่ลำพัง จะถูกลบออก และระบบจะรายงานว่าลบไปกี่บรรทัด
ระบบบอกว่าตรงไหนทำไม่สำเร็จ
หน้าที่จัดเป็นหลายคอลัมน์ บรรทัดที่ดูเหมือนแถวของตาราง รูปภาพที่ตัดออกมาไม่ได้ ข้อความที่ตะแคง และหน้าที่ไม่มีข้อความเลย จะถูกนับและอธิบายไว้ใต้ปุ่มดาวน์โหลดทีละอย่าง
วิธีใช้
เลือกไฟล์ PDF หนึ่งไฟล์หรือมากกว่า ถ้ามีไฟล์สแกนอยู่ด้วย ให้ติ๊กช่อง OCR และเลือกภาษาของไฟล์นั้นก่อนเริ่ม
กดเริ่ม ทุกหน้าถูกอ่านสองรอบ เอกสารยาวจึงใช้เวลาสักพัก
ดาวน์โหลดไฟล์ .docx แล้วอ่านหมายเหตุใต้ปุ่ม ตรงนั้นบอกว่าอะไรบ้างที่ไม่รอดมา
คนใช้ตอนไหน
คุณต้องแก้ข้อความสองย่อหน้าในไฟล์ PDF ของคนอื่น
นำเงื่อนไขของผู้ขายมาใช้ซ้ำ ข้อหนึ่งในสัญญา หรือหัวข้อหนึ่งในรายงาน
เอาข้อความออกมาโดยไม่ต้องพิมพ์ใหม่
ข้อเสนอ บทความ หรือคู่มือที่มีอยู่แค่ในรูปแบบ PDF ขณะที่เนื้อความต้องไปอยู่ในที่ที่คุณแก้ไขได้
ไฟล์นี้ส่งไปเซิร์ฟเวอร์ของคนแปลกหน้าไม่ได้
สัญญา ใบรับรองแพทย์ สลิปเงินเดือน และอะไรก็ตามที่อยู่ใต้ข้อตกลงรักษาความลับ ไฟล์ PDF ถูกอ่านบนเครื่องของคุณเอง และไม่มีอะไรถูกส่งออกไป
คำถาม
ไฟล์ Word จะหน้าตาเหมือนไฟล์ PDF ไหม
ไม่เหมือน ระบบวางข้อความกลับตามลำดับการอ่านโดยใช้สไตล์ของ Word เอง บนหน้ากระดาษขนาดเท่าต้นฉบับ และใช้ระยะขอบที่ถอดมาจากตำแหน่งที่ข้อความวางอยู่จริง ตำแหน่งขึ้นบรรทัดใหม่ ฟอนต์ที่ใช้จริง ระยะห่างระหว่างตัวอักษร การแบ่งคอลัมน์ และทุกอย่างที่วาดเป็นภาพเวกเตอร์ จะไม่ถูกทำซ้ำ
ตารางจะเป็นอย่างไร
ตารางไม่ได้ออกมาเป็นตารางของ Word เมื่อบรรทัดหนึ่งมีช่องว่างกว้าง ๆ อยู่ข้างใน ช่องว่างเหล่านั้นจะกลายเป็นอักขระแท็บ และบรรทัดนั้นกลายเป็นย่อหน้าของตัวเอง ข้อมูลจึงอยู่ครบและเรียงถูกลำดับ ถ้าอยากได้ตารางจริง ๆ กลับมา ให้เลือกบรรทัดเหล่านั้นใน Word แล้วใช้ แทรก → ตาราง → แปลงข้อความเป็นตาราง โดยเลือกแท็บเป็นตัวคั่น รายงานจะบอกว่ามีกี่บรรทัดที่ออกมาแบบนี้
แล้วหน้าที่จัดเป็นสองคอลัมน์ล่ะ
แต่ละคอลัมน์ถูกอ่านจากบนลงล่างทีละคอลัมน์ และระบบจะรายงานให้คุณตรวจสอบเอง สามคอลัมน์ก็ทำแบบเดียวกัน สิ่งที่ทำให้พังคือหน้าที่คอลัมน์เริ่มและจบกลางหน้า หรือแถบข้างที่ทับกับเนื้อความหลัก หน้าแบบนั้นจะออกมาสลับกันไปมา
ไฟล์ PDF ของฉันเป็นภาพสแกน และไฟล์ Word ที่ได้ว่างเปล่า
หน้าที่สแกนมาไม่มีตัวอักษรอยู่ข้างในให้อ่าน ให้ติ๊ก “อ่านหน้าที่สแกนด้วย OCR” ระบุว่าไฟล์สแกนของคุณเป็นภาษาอะไร แล้วหน้าเหล่านั้นจะถูกรู้จำแทน ระบบอ่านอังกฤษ จีนตัวย่อและตัวเต็ม สเปน โปรตุเกส และรัสเซีย ได้ครั้งละหนึ่งภาษา เลือกผิดจึงได้ข้อความที่อ่านไม่รู้เรื่องกลับมา ใช้เวลาหลายวินาทีต่อหน้า และสิ่งที่ได้กลับมาคือข้อความล้วน ไม่มีหัวข้อและไม่มีตัวหนา
ตัวหนากับตัวเอียงเชื่อถือได้ไหม
ทั้งสองอย่างมาจากฟอนต์ที่ใช้วาดตัวอักษรแต่ละช่วง จึงถูกต้องทุกครั้งที่เอกสารใช้ฟอนต์ตัวหนาหรือตัวเอียงของจริง จะผิดเมื่อไฟล์ PDF ปลอมตัวหนาด้วยการวาดเส้นรอบตัวอักษรซ้ำสองครั้ง และอาจผิดกับฟอนต์ธรรมดาที่ถูกเอียง ขีดเส้นใต้ สีข้อความ และการไฮไลต์จะไม่ถูกนำติดไปด้วย
แปลงหลายไฟล์พร้อมกันได้ไหม
ได้ ไฟล์ PDF แต่ละไฟล์ได้ไฟล์ .docx ของตัวเอง เกินสามไฟล์จะมาเป็นไฟล์ zip เดียว ไฟล์ PDF ที่ใหญ่เกิน 2 GB เปิดไม่ได้เลย นั่นคือขีดจำกัดของเบราว์เซอร์
ไฟล์ของฉันถูกอัปโหลดไหม
ไม่ ไฟล์ PDF ถูกหน้านี้อ่านจากดิสก์ของคุณ ไฟล์ Word ถูกประกอบขึ้นในแท็บนี้ และการดาวน์โหลดออกมาจากเบราว์เซอร์ของคุณเอง คุณเปิดแท็บเครือข่ายดูระหว่างที่มันทำงานได้ ตัวอ่าน PDF และกลไก OCR ถูกดาวน์โหลดจากเว็บไซต์นี้ในครั้งแรก เอกสารของคุณไม่ได้อยู่ในนั้น
เครื่องมืออื่น
บีบอัดรูป
ย่อรูปโดยไม่ต้องอัปโหลด
บีบอัด PDF
ย่อไฟล์ PDF โดยไม่ต้องอัปโหลด
บีบอัดวิดีโอ
ทำให้ไฟล์วิดีโอเล็กลง
ครอปวิดีโอ
ลากกรอบบนภาพ แล้วเก็บไว้เฉพาะส่วนนั้น
วิดีโอเป็น GIF
เปลี่ยนวิดีโอบางช่วงให้เป็น GIF เคลื่อนไหว
รวมไฟล์ PDF
รวมไฟล์ PDF หลายไฟล์เป็นไฟล์เดียว
แยกไฟล์ PDF
ดึงหน้าออกมาจากไฟล์ PDF
PDF เป็น JPG
เปลี่ยนทุกหน้าของ PDF ให้เป็นภาพ
ตัดไฟล์เสียง
ตัดไฟล์เสียงให้เหลือเฉพาะช่วงที่ต้องการ
ตัดช่วงวิดีโอ
เอาวิดีโอมาเฉพาะช่วงโดยไม่บีบอัดใหม่
ครอปรูปภาพ
ลากกรอบทับบนรูป แล้วหมุนถ้าจำเป็น
รวมรูปภาพ
เอาหลายรูปมารวมเป็นไฟล์เดียว
HEIC เป็น JPG
แปลงรูปจาก iPhone ให้เป็น JPG
JPG เป็น PDF
รวมรูป JPG และ PNG เป็น PDF ไฟล์เดียว
วิดีโอเป็น MP3
ดึงเสียงออกจากวิดีโอ
Word เป็น PDF
เปลี่ยน .docx เป็น PDF หรือหน้าละหนึ่งไฟล์ PDF
Markdown เป็น Word
เปลี่ยนไฟล์ .md ให้เป็น .docx
Markdown เป็น PowerPoint
เปลี่ยนโครงร่าง Markdown ให้เป็นสไลด์
รูปเป็นข้อความ
อ่านข้อความออกมาจากรูป
แยกแผ่นงาน Excel
หนึ่งแผ่นงาน หนึ่งไฟล์
แยกแถว Excel
หนึ่งแถว หนึ่งไฟล์