PDF zu Word
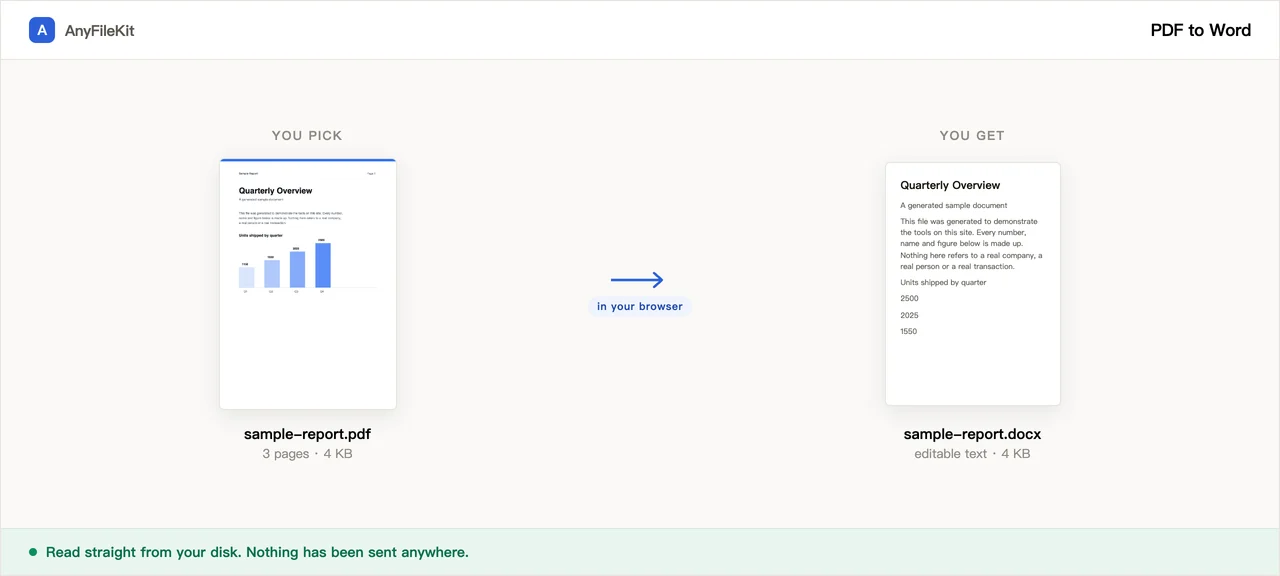
Ein PDF enthält keine Absätze, nur Zeichen mit einer Position auf der Seite. Diese Seite liest diese Positionen zurück und ermittelt daraus wieder die Absätze, die Überschriften und die Lesereihenfolge. Bei einem gewöhnlichen einspaltigen Dokument geht das gut, bei allem, was als Raster gesetzt ist, schlecht. Nach jedem Durchlauf sagt sie Ihnen, welches von beiden Sie hatten.
- Kein Konto
- Kein Wasserzeichen
- Keine Größenbegrenzung
Deine Dateien
Am besten bei gewöhnlichen einspaltigen Dokumenten. Tabellen, mehrspaltige Seiten und alles, was als Zeichnung angelegt ist, überstehen das nicht unversehrt. Die Hinweise nach dem Lauf sagen, was mit Ihrem Dokument passiert ist.
An die OCR gehen nur Seiten, die gar keinen Text enthalten. Beim ersten Lauf werden die Erkennungsmaschine und das eine Sprachpaket, das Sie gewählt haben, heruntergeladen, zusammen etwa 3,5 MB. Danach dauert es mehrere Sekunden pro Seite und es kommt reiner Text zurück, ohne Überschriften und ohne Fettung. Nur gedruckter Text: Handschrift kommt als Unsinn zurück, welche Sprache Sie auch wählen.
Standardmäßig aus, damit ein Absatz, der über zwei PDF-Seiten zerteilt ist, wieder zusammengefügt wird. Schalten Sie es ein, wenn die Word-Datei genauso umbrechen muss wie das PDF.
Noch nichts ausgewählt.
Was dieses Werkzeug für dich tut
Was du vor dem Start wissen solltest.
Absätze, nicht eine Zeile pro Absatz
Ein PDF hält gedruckte Zeilen fest, keine Absätze. Dieses Werkzeug fügt die Zeilen wieder zusammen, auch Wörter, die mit Bindestrich über eine Zeile getrennt sind, und beginnt einen neuen Absatz nur dort, wo sich Zeilenabstand, Einzug, Schriftgröße oder Fettung ändern.
Überschriften werden zu Word-Überschriften
Text, der größer gesetzt ist als der Fließtext, wird nach Größe sortiert und auf Überschrift 1, 2 und 3 abgebildet, so dass sich der Navigationsbereich füllt und Verweise → Inhaltsverzeichnis funktioniert. Fett und kursiv kommen aus der Schrift, mit der der jeweilige Zeichenabschnitt gezeichnet wurde.
Laufende Kopfzeilen und Seitenzahlen fallen weg
Zeilen, die im oberen oder unteren Rand stehen und sich über die Hälfte des Dokuments wiederholen, sowie bloße Seitenzahlen werden entfernt. Die Anzahl der entfernten Zeilen wird gemeldet.
Es meldet, wo es gescheitert ist
Mehrspaltige Seiten, tabellenartige Zeilen, Bilder, die nicht herausgelöst werden konnten, quer stehender Text und Seiten ganz ohne Text werden einzeln gezählt und unter dem Download-Knopf erklärt.
So benutzt du es
Wählen Sie ein oder mehrere PDFs. Falls Scans dabei sind, setzen Sie vor dem Start das Häkchen bei OCR und wählen Sie deren Sprache.
Starten Sie den Lauf. Jede Seite wird zweimal gelesen, ein langes Dokument dauert also eine Weile.
Laden Sie das .docx herunter und lesen Sie dann die Hinweise unter dem Knopf. Dort steht, was nicht überlebt hat.
Wann man es braucht
Sie müssen zwei Absätze aus dem PDF eines anderen bearbeiten
Die Bedingungen eines Lieferanten weiterverwenden, eine Klausel aus einem Vertrag, einen Abschnitt eines Berichts.
Den Text herausholen, ohne ihn abzutippen
Ein Angebot, ein Artikel oder ein Handbuch, das es nur als PDF gibt, und der Fließtext muss irgendwo landen, wo Sie damit arbeiten können.
Die Datei darf nicht auf den Server eines Fremden
Verträge, Arztbriefe, Gehaltsabrechnungen, alles unter einer Geheimhaltungsvereinbarung. Das PDF wird auf Ihrem eigenen Rechner gelesen, und es wird nichts gesendet.
Fragen
Sieht die Word-Datei aus wie das PDF?
Nein. Sie setzt den Text in Lesereihenfolge mit Words eigenen Formatvorlagen zurück, auf eine Seite in der Größe des Originals, mit Rändern, die daraus abgeleitet sind, wo der Text tatsächlich steht. Zeilenumbrüche, exakte Schriften, Laufweite, Spalten und alles, was als Vektorgrafik gezeichnet ist, werden nicht nachgebildet.
Was passiert mit Tabellen?
Sie kommen nicht als Word-Tabellen heraus. Wenn eine Zeile breite Lücken enthält, werden diese Lücken zu Tabulatorzeichen und die Zeile wird ein eigener Absatz, die Daten sind also vollständig und in der richtigen Reihenfolge da. Um eine echte Tabelle zurückzubekommen, markieren Sie diese Zeilen in Word und verwenden Einfügen → Tabelle → Text in Tabelle umwandeln mit Tabstopps als Trennzeichen. Der Bericht sagt, wie viele Zeilen so herausgekommen sind.
Und zweispaltige Seiten?
Jede Spalte wird der Reihe nach von oben nach unten gelesen, und das wird gemeldet, damit Sie es prüfen können. Drei Spalten funktionieren genauso. Was daran scheitert, ist eine Seite, auf der die Spalten auf halber Höhe beginnen und enden, oder eine Randspalte, die den Haupttext überlappt; solche Seiten kommen verschränkt heraus.
Mein PDF ist ein Scan und die Word-Datei ist leer.
In einer gescannten Seite stecken keine Zeichen, die man lesen könnte. Setzen Sie das Häkchen bei „Gescannte Seiten mit OCR lesen“, geben Sie an, in welcher Sprache Ihr Scan ist, und diese Seiten werden stattdessen erkannt. Erkannt werden Englisch, Chinesisch in Kurz- und Langzeichen, Spanisch, Portugiesisch und Russisch, immer nur eine Sprache auf einmal, eine falsche Wahl kommt also als Unsinn zurück. Es dauert mehrere Sekunden pro Seite, und zurück kommt reiner Text, ohne Überschriften und ohne Fettung.
Sind fett und kursiv verlässlich?
Sie kommen aus der Schrift, mit der der jeweilige Zeichenabschnitt gezeichnet wurde, sie stimmen also immer dann, wenn das Dokument eine echte fette oder kursive Schrift verwendet hat. Falsch liegen sie, wenn ein PDF die Fettung vorgetäuscht hat, indem es jede Kontur zweimal zeichnet, und sie können bei einer schräg gestellten normalen Schrift falsch liegen. Unterstreichung, Textfarbe und Hervorhebung werden nicht übernommen.
Kann ich mehrere Dateien auf einmal umwandeln?
Ja. Jedes PDF wird ein eigenes .docx. Ab vier Dateien kommen sie als ein einziges ZIP. Ein PDF über 2 GB lässt sich überhaupt nicht öffnen; das ist die Grenze des Browsers.
Wird meine Datei hochgeladen?
Nein. Das PDF wird von dieser Seite von Ihrer Festplatte gelesen, die Word-Datei wird im Tab zusammengebaut, und der Download kommt aus Ihrem eigenen Browser. Sie können den Netzwerk-Tab offen lassen, während es läuft. Der PDF-Leser und die OCR-Maschine werden beim ersten Mal von dieser Website geladen; Ihr Dokument ist nicht Teil davon.
Andere Werkzeuge
Bild komprimieren
Fotos kleiner machen, ohne sie hochzuladen
PDF komprimieren
Ein PDF verkleinern, ohne es hochzuladen
Video komprimieren
Eine Videodatei kleiner machen
Video zuschneiden
Ziehen Sie einen Rahmen über das Bild und behalten Sie nur diesen Teil
Video zu GIF
Machen Sie aus einem Teil eines Videos ein animiertes GIF
PDF zusammenfügen
Mehrere PDFs zu einem verbinden
PDF teilen
Seiten aus einem PDF herausholen
PDF zu JPG
Jede Seite eines PDF wird ein Bild
Audio schneiden
Eine Audiodatei kürzen
Video schneiden
Ein Video kürzen, ohne es neu zu kodieren
Bild zuschneiden
Zieh einen Rahmen darüber und dreh es, wenn es nötig ist
Bilder zusammenfügen
Mehrere Bilder in einer Datei
HEIC zu JPG
iPhone-Fotos in JPG umwandeln
JPG zu PDF
JPG- und PNG-Bilder zu einem PDF machen
Video zu MP3
Den Ton aus einem Video herausholen
Word zu PDF
Aus einer .docx wird ein PDF, oder ein PDF pro Seite
Markdown zu Word
Machen Sie aus einer .md-Datei eine .docx-Datei
Markdown zu PowerPoint
Aus einer Markdown-Gliederung werden Folien
Bild zu Text
Den Text aus einem Bild auslesen
Excel-Blätter aufteilen
Ein Blatt, eine Datei
Excel-Zeilen aufteilen
Eine Zeile, eine Datei